سامانه هوشمند RAG Core
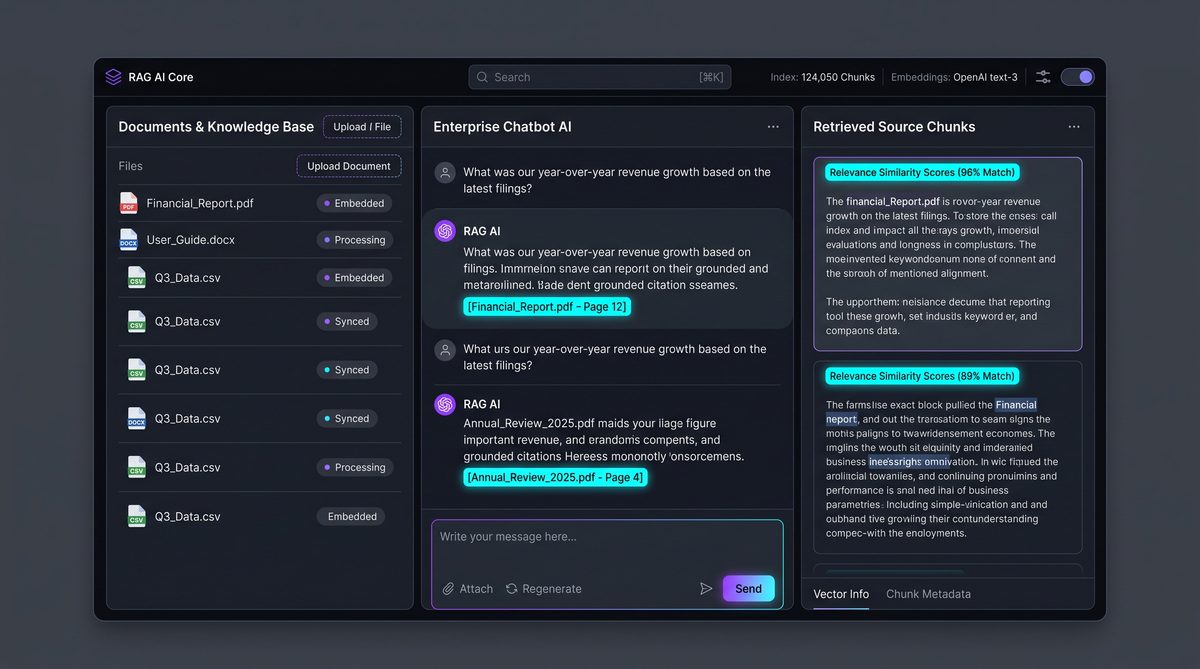
سامانه پیشرفته بازیابی اطلاعات تقویتشده با تولید متن (RAG) سازمانی جهت ایندکس و پردازش بیش از ۱۲۴,۰۰۰ سند فنی، کاتالوگ و مقالات پژوهشی با تلفیق جستجوی متراکم برداری و BM25، بازرتبهبندی با کراسانکودر و استناد دقیق به صفحه و پاراگراف اسناد مرجع.
چه مانع یا چالشی نیاز به حل داشت؟
۱. توهم و خطاهای اطلاعاتی مدلهای زبانی (Hallucinations): مدلهای زبانی عمومی در پاسخگویی به سوالات سازمانی، اسناد مالی و مشخصات فنی داخلی اطلاعات غیرواقعی یا منسوخ تولید میکنند. ۲. پراکندگی فرمتهای اسناد سازمانی و جداول چندستونه: اسناد شامل فایلهای PDF چندستونه اسکنشده، جداول پیچیده، نقشههای فنی و فایلهای متنی بدون ساختار استاندارد هستند. ۳. چالشهای کیفیت بازیابی در جستجوی صرفاً برداری: روشهای سنتی نزدیکترین همسایه برداری روی واژگان خاص مانند شماره سریالها، نسخههای نرمافزاری و علائم اختصاری عملکرد ضعیفی دارند.
معماری سیستم و نحوه پیادهسازی
• معماری بازیابی ترکیبی (Hybrid Search): ادغام بردارهای معنایی عمیق (BGE-M3 / OpenAI) با نمایه واژگانی BM25 در دیتابیس برداری Qdrant با استفاده از الگوریتم تلفیق رتبهبندی متقابل (RRF). • بازرتبهبندی پیشرفته (Cross-Encoder Re-Ranking): پیادهسازی مدل بازرتبهبندی برای ارزیابی مجدد ۳۰ تکه متن منتخب و فشردهسازی زمینه (Context Compression) جهت تزریق بهینه به کانتکست LLM. • سامانه ضدتوهم با استناد دقیق به شماره صفحه و اسناد: ایجاد لایه اعتبارسنجی ارجاعات که هر جمله خروجی را با شماره صفحه، سرفصل سند مرجع و درصد اطمینان معنایی ۹۶٪ به کاربر متصل میسازد.
ارزش ایجاد شده
• ایندکس و سازماندهی بیش از ۱۲۴,۰۰۰ سند سازمانی با دقت بازیابی معنایی ۹۶.۲ درصد. • کاهش ۸۴ درصدی توهم مدلهای زبانی از طریق الزام به استناد صریح به منبع، فصل و صفحه اسناد مرجع. • زمان پردازش و بازیابی زیر ۲۸۰ میلیثانیه برای جستجوی برداری ترکیبی در میان میلیونها قطعه متنی.
نیاز به پیادهسازی سیستمی مشابه دارید؟
برای مشاوره فنی، امکانسنجی یا توسعه پروژههای استخراج داده و هوش مصنوعی در ارتباط باشید.