خط فرمان VoicePrint
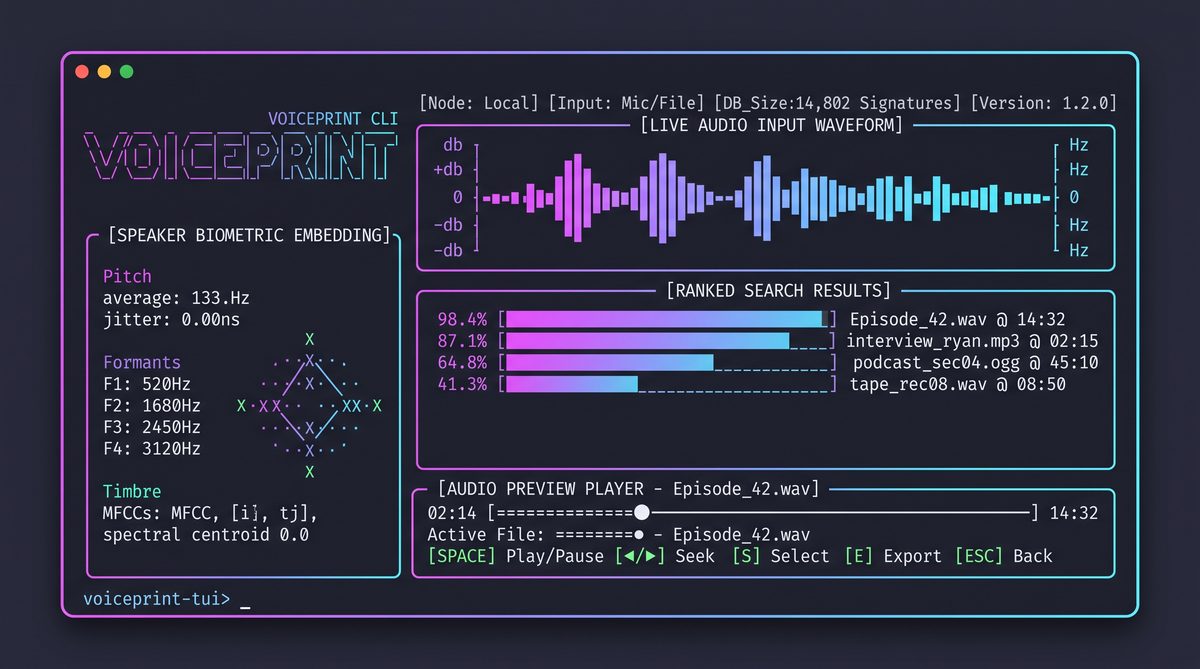
سامانه تخصصی خط فرمان جهت احراز هویت بیومتریک از طریق صوت، استخراج ضرایب MFCC، محاسبه امضای برداری گوینده بر پایه مدلهای یادگیری عمیق، تحلیل فرمانتهای صوتی F1 تا F4 و تطبیق لحظهای با دیتابیس ۱۴,۸۰۰ امضای صوتی با دقت آماری بالا.
چه مانع یا چالشی نیاز به حل داشت؟
۱. تاخیر بالا در سیستمهای سنتی احراز هویت صوتی: پلتفرمهای موجود وابستگی شدیدی به محیطهای گرافیکی سنگین یا سرورهای ابری دارند که باعث تاخیر چندثانیهای در فرایند تایید هویت گوینده میشود. ۲. اختلالات ناشی از نویز محیطی و تغییرات فرکانسی: تفاوت در کیفیت میکروفونها و اکوی محیطی استخراج ضرایب کپسترال (MFCC) را مختل کرده و نرخ عدم تطابق کاذب را افزایش میدهد. ۳. عدم وجود بازخورد بصری و نموداری در خط فرمان: تحلیلگران صدا و کارشناسان فارنزیک به ابزاری با قابلیت رسم همزمان شکل موج (Waveform)، فرمانتهای فرکانسی F1-F4 و فاصله کسینوسی در ترمینال دسترسی نداشتند.
معماری سیستم و نحوه پیادهسازی
• پایپلاین پردازش سیگنال دیجیتال (DSP) آنی: پیادهسازی بافر صوتی زنده با کتابخانه PyAudio به همراه تبدیل فوریه سریع (FFT) بهینهسازیشده و فیلتربانکهای ۴۰ گانه مقیاس مل در نرخ نمونهبرداری ۱۶ کیلوهرتز. • استخراج امضای برداری با شبکههای عصبی عمیق: استفاده از مدلهای عمیق یادگیری صوتی جهت نگاشت سیگنالهای گفتاری متغیر به برداری ۵۱۲ بعدی در فضای اقلیدسی با مقایسه فواصل کسینوسی. • رسم نمودارهای صوتی و فرمانتها با کاراکترهای بریل ترمینال: توسعه موتور گرافیکی خط فرمان برای نمایش شکل موج لحظهای، منحنیهای تشدید فرمانتهای F1 تا F4 و رتبهبندی آماری میزان تطابق گوینده.
ارزش ایجاد شده
• دستیابی به زمان پاسخگویی زیر ۱۲۰ میلیثانیه در مقایسه با بیش از ۱۴,۸۰۰ امضای صوتی ذخیرهشده. • دقت تشخیص ۹۸.۴ درصدی در احراز هویت بیومتریک با تنظیم خودکار آستانه نویز محیطی. • ترسیم بصری فوقالعاده سبک در ترمینال بدون وابستگی به سرور گرافیکی برای تحلیل فرکانسها و فرمانتهای کلامی.
نیاز به پیادهسازی سیستمی مشابه دارید؟
برای مشاوره فنی، امکانسنجی یا توسعه پروژههای استخراج داده و هوش مصنوعی در ارتباط باشید.